AIOps / Sep 12, 2026 / 10 min
Agent RCA: 검증 가능한 Evidence로 MTTR을 줄이기 위한 설계
Kubernetes 장애를 재현하고 관측 근거를 수집하는 RCA Agent를 만들었다. 조사 범위와 Evidence Gate를 설계한 이유, 초기 평가 실패를 고친 과정, 실제로 확인한 결과를 정리한다.
Why I Built It
서비스 오류율이 올라갔다는 알림을 받았다고 해보자. 알림만으로는 배포 문제인지, Pod가 재시작한 것인지, 다른 서비스로 가는 통신이 막힌 것인지 알 수 없다. Prometheus에서 metric을 보고, Kubernetes 상태와 Event를 확인하고, 로그와 변경 이력을 대조해야 한다.
이 프로젝트에서 줄이고 싶었던 것은 그 초기 조사 과정이었다. 관련 데이터를 모으고 같은 리소스와 시간대의 정보인지 확인하는 일을 시스템이 먼저 해두면, 운영자는 원인 후보와 근거를 검토하는 데 집중할 수 있을 것이라고 생각했다.
AIOps Agent 구축 사례들을 읽으며 참고한 것도 이 지점이었다. 여러 관측 도구를 Agent에 연결하면 조사를 도울 수 있다. 그렇다면 Agent가 내놓은 결론을 어디까지 받아들일 것인가? 그 질문을 실제 장애 환경에서 확인해보고 싶었다.
그래서 GCP에 Kubernetes 실험 환경을 만들고, 마이크로서비스 예제인 Google Online Boutique에 장애를 재현하면서 Agent RCA를 구현했다. 목표는 운영자의 초기 조사 시간을 줄이는 것이지만, 실제 운영팀의 MTTR 감소를 측정한 프로젝트는 아니다. 여기서는 무엇을 만들었고, 어떤 실패를 고쳤으며, 어디까지 확인했는지를 정리한다.
Design Principles
첫 번째는 결론에서 근거로 돌아갈 수 있어야 한다는 것이었다. “메모리 문제로 보인다”는 답변보다 어느 Pod의 어떤 종료 상태와 restart 기록을 확인했는지가 필요했다. 이를 위해 수집한 관측에 evidence_id를 붙이고, Report가 그 ID를 인용하도록 했다.
두 번째는 조사 범위를 통제하는 것이었다. Agent가 cluster 전체를 자유롭게 조회하면 관련 없는 리소스를 섞거나, 복구된 현재 상태를 장애 당시 상태로 해석할 수 있다. 서비스·시간·조회량을 제한하고, 분석에 사용한 데이터를 보존하기로 했다.
세 번째는 판단 유보를 정상적인 결과로 두는 것이었다. 필요한 관측이 없는데 매번 원인을 확정하면 운영자가 결과를 신뢰하기 어렵다. 증명이 부족한 경우에는 ABSTAIN을 남기고, 근거 없는 확정 결론은 별도로 거절하도록 했다.
마지막으로 진단과 조치를 분리했다. Agent는 read-only 도구로 조사하고 복구 방향을 제안할 수 있지만, shell이나 kubectl을 실행해 운영 리소스를 변경하지 않는다.
How It Works
검증 환경은 GCP Compute Engine VM 세 대에 각각 kubeadm 기반 single-node Kubernetes를 설치해 구성했다. Terraform과 Ansible로 환경을 만들고, containerd와 Cilium/Hubble을 사용했다.
세 환경의 역할을 나눈 이유는 장애를 주입하는 서비스와 그것을 관측·분석하는 시스템을 분리하기 위해서였다.
| 환경 | 배치한 구성 |
|---|---|
| Fault target | Online Boutique, Chaos Mesh, telemetry 수집·전달 구성 |
| Observability | Prometheus, Alertmanager, Loki, Tempo, Grafana |
| RCA control | Receiver, PostgreSQL queue, 수집·분석 worker, Neo4j, Viewer |
이 구성은 장애 실험의 영향을 분리하기 위한 것이다. 각 환경 자체는 single-node이므로 production HA를 구현한 것은 아니다. 도메인 간 조회는 사설 VPC 경로를 사용하고, RCA worker에는 장애 대상 cluster의 제한된 read-only 권한을 부여했다.
Separating Alert Ingestion from Analysis
Prometheus rule이 발화하면 Alertmanager가 인증된 Receiver로 알림을 전달한다. Receiver는 알림을 정규화하고 중복을 처리한 뒤 PostgreSQL에 Incident를 저장한다. 실제 수집과 분석은 별도의 worker가 맡는다.
HTTP 요청 안에서 관측 소스 조회와 LLM 실행까지 끝내도록 만들면, 느린 조회나 분석 실패가 알림 수신 경로에 영향을 준다. 그래서 PostgreSQL에 저장한 작업을 worker가 claim하는 구조로 나눴다.
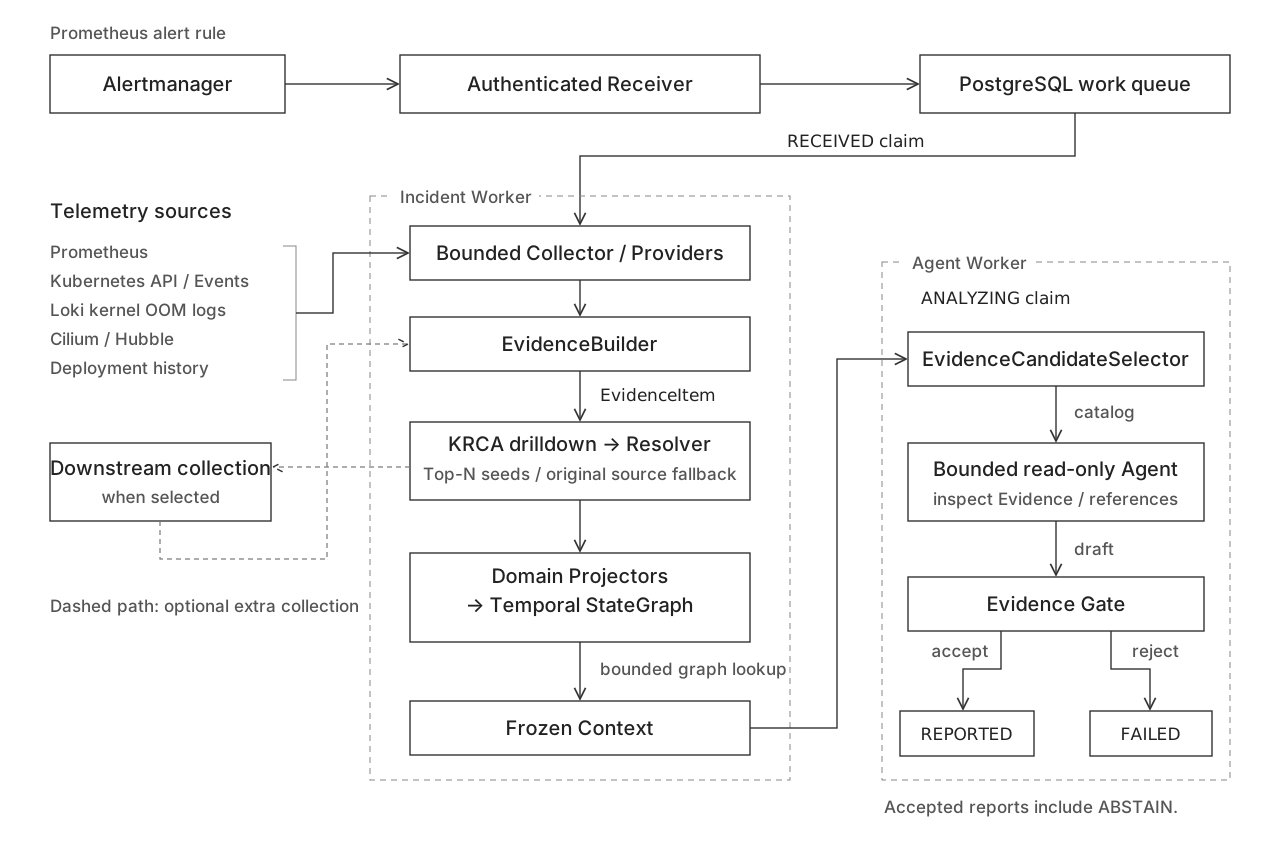
초기 Graph 관측 반영과 저장소 내부 작업을 생략한 처리 흐름이다. 추가 수집을 마친 뒤 최종 Context를 고정한다.
수집 worker는 Prometheus metric, Kubernetes API·Event, Loki의 kernel OOM 로그, Deployment history와 Hubble flow를 조회한다. 여기서 Alertmanager는 알림 전달을 담당하고, 각 관측 소스 조회는 Collector와 Provider가 담당한다.
Tempo에는 trace를 저장했지만 trace 자체를 Incident Evidence로 가져오는 Provider는 아직 연결하지 않았다. 일반 application log도 마찬가지다. 관측 시스템에 데이터가 존재하는 것과 Agent가 그 데이터를 근거로 사용할 수 있는 것은 별도의 연결 작업이었다.
Connecting Evidence to the Same Incident
Provider마다 응답 형식이 다르기 때문에 결과를 바로 Agent에 전달하지 않았다. Provider가 반환한 EvidenceDraft를 EvidenceBuilder에 통과시켜 공통 EvidenceItem으로 만들었다.
이 과정에서 요청한 시간·리소스 범위에 맞는지 검사하고, 민감한 값을 제거하며, 출처와 query locator, content hash를 기록한다. JSON Schema로 형식도 검증한다. 형식을 통일하는 것만으로 원인이 증명되는 것은 아니지만, 서로 다른 관측을 대조하고 나중에 다시 확인할 기반은 만들 수 있다.
예를 들어 같은 이름의 Pod라도 재생성됐다면 다른 리소스다. Kubernetes UID와 cluster·namespace를 함께 확인해야 이전 Pod의 Event를 새 Pod의 장애 근거로 사용하는 일을 막을 수 있다.
검증된 Evidence는 Domain Projector를 통해 Entity와 시간별 상태·관계로 변환해 Temporal StateGraph에 반영한다. 이 Graph에서 필요한 범위를 조회한 뒤 Evidence와 수집 실패·완전성 정보를 Frozen Context로 고정한다. 이후 서비스가 복구되더라도 Agent가 무엇을 보고 판단했는지 추적할 수 있다.
다만 Frozen Context가 관측하지 못한 과거까지 복원하지는 않는다. 수집하거나 보존하지 못한 정보는 누락으로 남는다.
Service Ranking and Evidence Selection
모든 서비스를 같은 깊이로 조사하지 않도록 KRCA 논문의 API-level drilldown을 참고했다. 허용된 API operation과 PromQL profile에서 오류율·latency 등의 시계열을 비교하고, 조사할 서비스 후보를 고르는 데 사용했다. KRCA 논문의 전체 causal graph와 multi-agent 시스템을 구현한 것은 아니다.
이 과정에는 서로 다른 두 가지 선택이 있다.
| 단계 | 결정하는 것 |
|---|---|
| KRCA-style ranking | API metric을 바탕으로 조사할 서비스 Top-N |
| EvidenceCandidateSelector | 최종 Context 안에서 Agent가 읽을 제한된 Evidence 목록 |
KRCA 후보를 exact Entity로 연결하고, 필요한 downstream Evidence를 추가 수집한 다음 Context를 고정한다. 그 뒤 EvidenceCandidateSelector가 원인별 증명에 필요한 근거를 우선 포함하고, 남은 예산 안에서 최신성·품질·관련성과 출처 다양성을 고려한다.
따라서 Kubernetes Event와 Hubble flow를 KRCA 수식으로 채점하는 것은 아니다. 이들도 Context에 포함되면 Evidence 선택과 Agent 조사에 참여한다. 두 단계의 점수는 조사 우선순위를 위한 값이며, 원인일 확률을 의미하지 않는다.
KRCA profile이 없거나 후보 선택·Entity 연결이 성립하지 않으면 원래 Incident 대상 기반으로 조사한다. 원래 대상도 연결하지 못하면 localization 실패로 남긴다. 한편 일부 API feature가 누락돼도 사용 가능한 feature에서 후보가 나오면 현재는 그 후보를 사용할 수 있다. 누락은 0점이나 정상이 아니지만, metric coverage가 조사 범위에 영향을 줄 수 있다는 한계가 있다.
Validating the Agent's Draft
Agent Worker는 ANALYZING Incident를 claim하고 Frozen Context를 조사한다. Agent가 사용하는 도구는 Evidence를 읽는 inspect_evidence와 운영 reference를 읽는 inspect_reference다. 기본 예산은 LLM 호출 최대 6회, tool 호출 최대 12회, Evidence 후보 8개, wall time 60초로 두었다.
Runbook이나 아키텍처 문서는 조사 방향을 잡는 데 사용할 수 있지만, 이번 장애의 발생 사실을 증명하지는 않는다. 최종 원인을 주장하려면 runtime Evidence를 인용해야 한다.
Agent가 초안을 만들면 Evidence Gate가 인용한 ID가 실제 Context 안에 있는지, 해당 Evidence를 읽었는지, 대상과 원인별 증명 조건이 맞는지 검사한다. 등록된 원인을 확정할 수 있는 근거가 부족한 초안은 통과하지 못한다.
Agent draft
  → Evidence Gate
      ├── accepted → REPORTED
      │               └── 판단 유보도 검증을 통과하면 ABSTAIN
      └── rejected → rejection audit + FAILED
여기서 ABSTAIN은 원인 없는 유효한 INCONCLUSIVE Report의 결과다. Agent가 근거 없이 확정한 결론을 Gate가 알아서 ABSTAIN으로 고치는 것은 아니다.
별도의 deterministic Fast Path도 구현했지만, 현재 연속 worker가 이를 먼저 실행하고 실패한 경우만 Agent로 보내는 자동 분기는 없다. 연속 Agent 경로에서는 초안 생성 후 Gate가 deterministic 원인별 규칙을 적용한다.
Fault Injection in Practice
OOM: What the Evidence Actually Proves
대표 OOM 사례에서는 checkoutservice의 resource limit을 변경하고 Chaos Mesh의 StressChaos로 부하를 주었다. Prometheus의 OOM/restart rule이 감지한 알림이 Receiver로 들어오고, 수집·분석을 거쳐 Report가 저장됐다.
이때 확인한 것은 높은 메모리 사용률 하나가 아니었다. Kubernetes의 OOM 종료 상태, 같은 Pod UID의 restart 증가, Loki의 kernel cgroup OOM 기록을 같은 시간 범위에서 대조했다.
Kubernetes 상태: Pod가 OOMKilled로 종료
Prometheus:      같은 Pod UID의 restart 증가
Loki:            해당 Pod cgroup의 OOM 기록
등록된 OOM 규칙은 exact Pod OOM 신호와 같은 Pod UID의 restart 증가를 요구한다. kernel 로그는 이 사례에서 추가로 확인한 근거다.
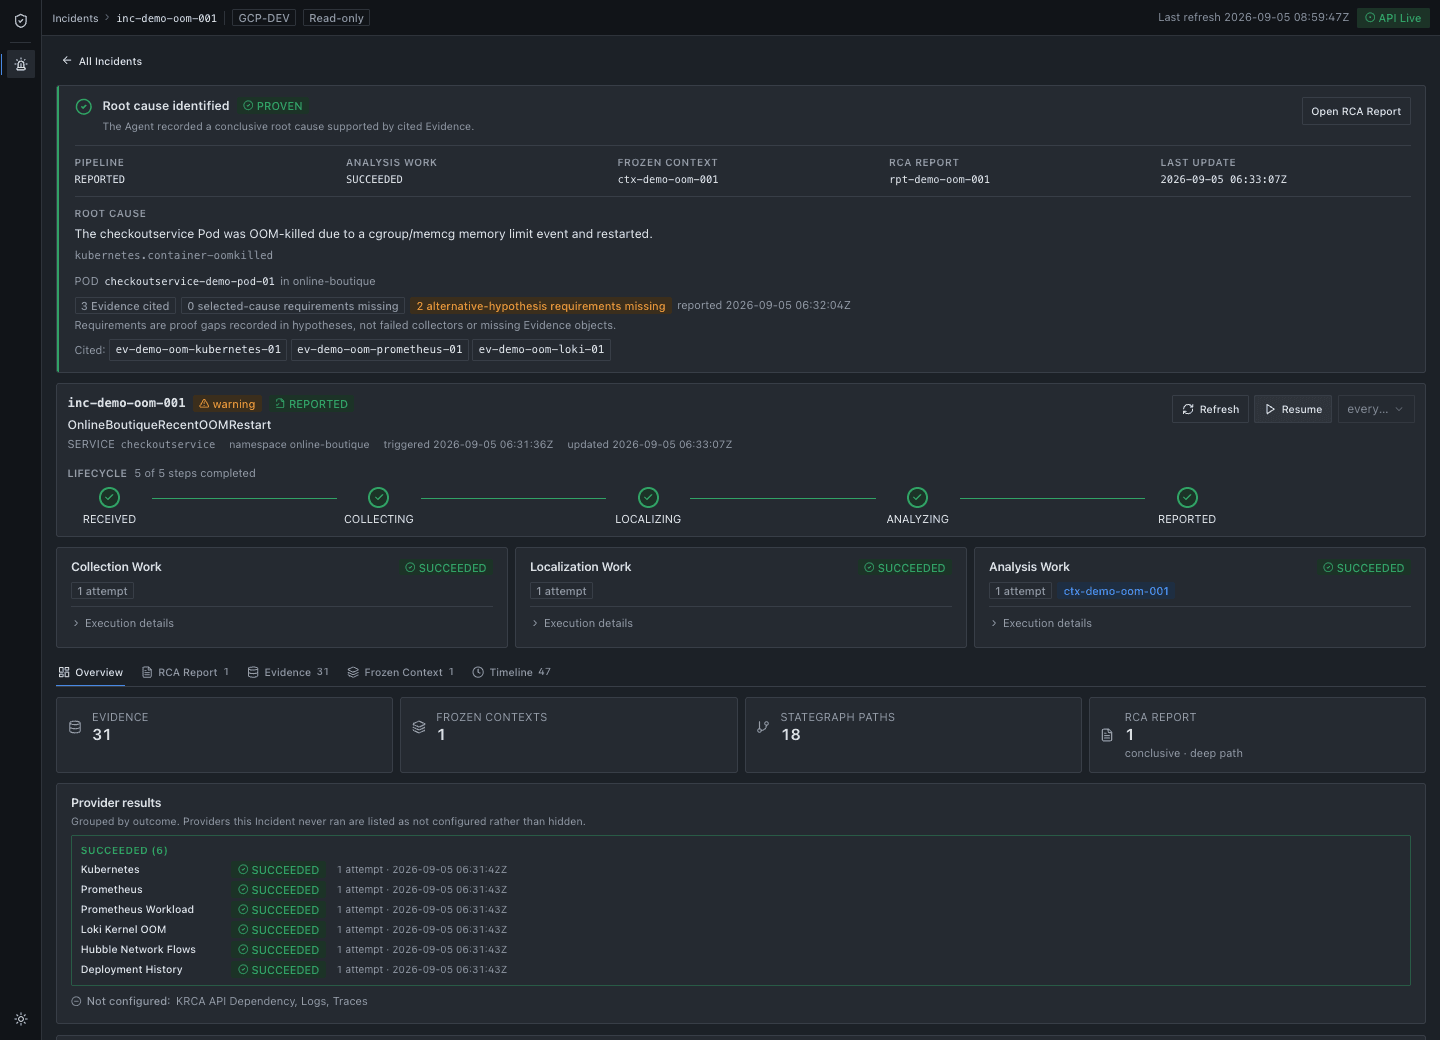
보존한 OOM 검증 사례의 공개용 Viewer 화면. Report의 인용을 따라 실제 관측 근거를 확인할 수 있다.
이 결과로 말할 수 있는 것은 해당 container가 memory limit과 관련된 OOM으로 종료됐다는 것이다. 애플리케이션 내부에 메모리 누수가 있었다거나, limit을 늘리는 것이 올바른 해결책이라는 결론까지 자동으로 따라오지는 않는다.
Report에는 확인한 범위까지만 원인으로 적고, 운영자가 추가로 판단할 부분을 남기는 것이 중요했다. 또 REPORTED는 보고서 저장 상태다. 실험 리소스의 복구는 평가 실행기가 수행했고 Agent가 직접 변경하지 않았다.
NetworkPolicy: Healthy Pods, Failing Requests
네트워크 쪽에서는 frontend → productcatalogservice:3550/TCP 통신을 정책으로 차단했다. 차단 중 상품 요청은 timeout됐지만 health check는 계속 성공했다.
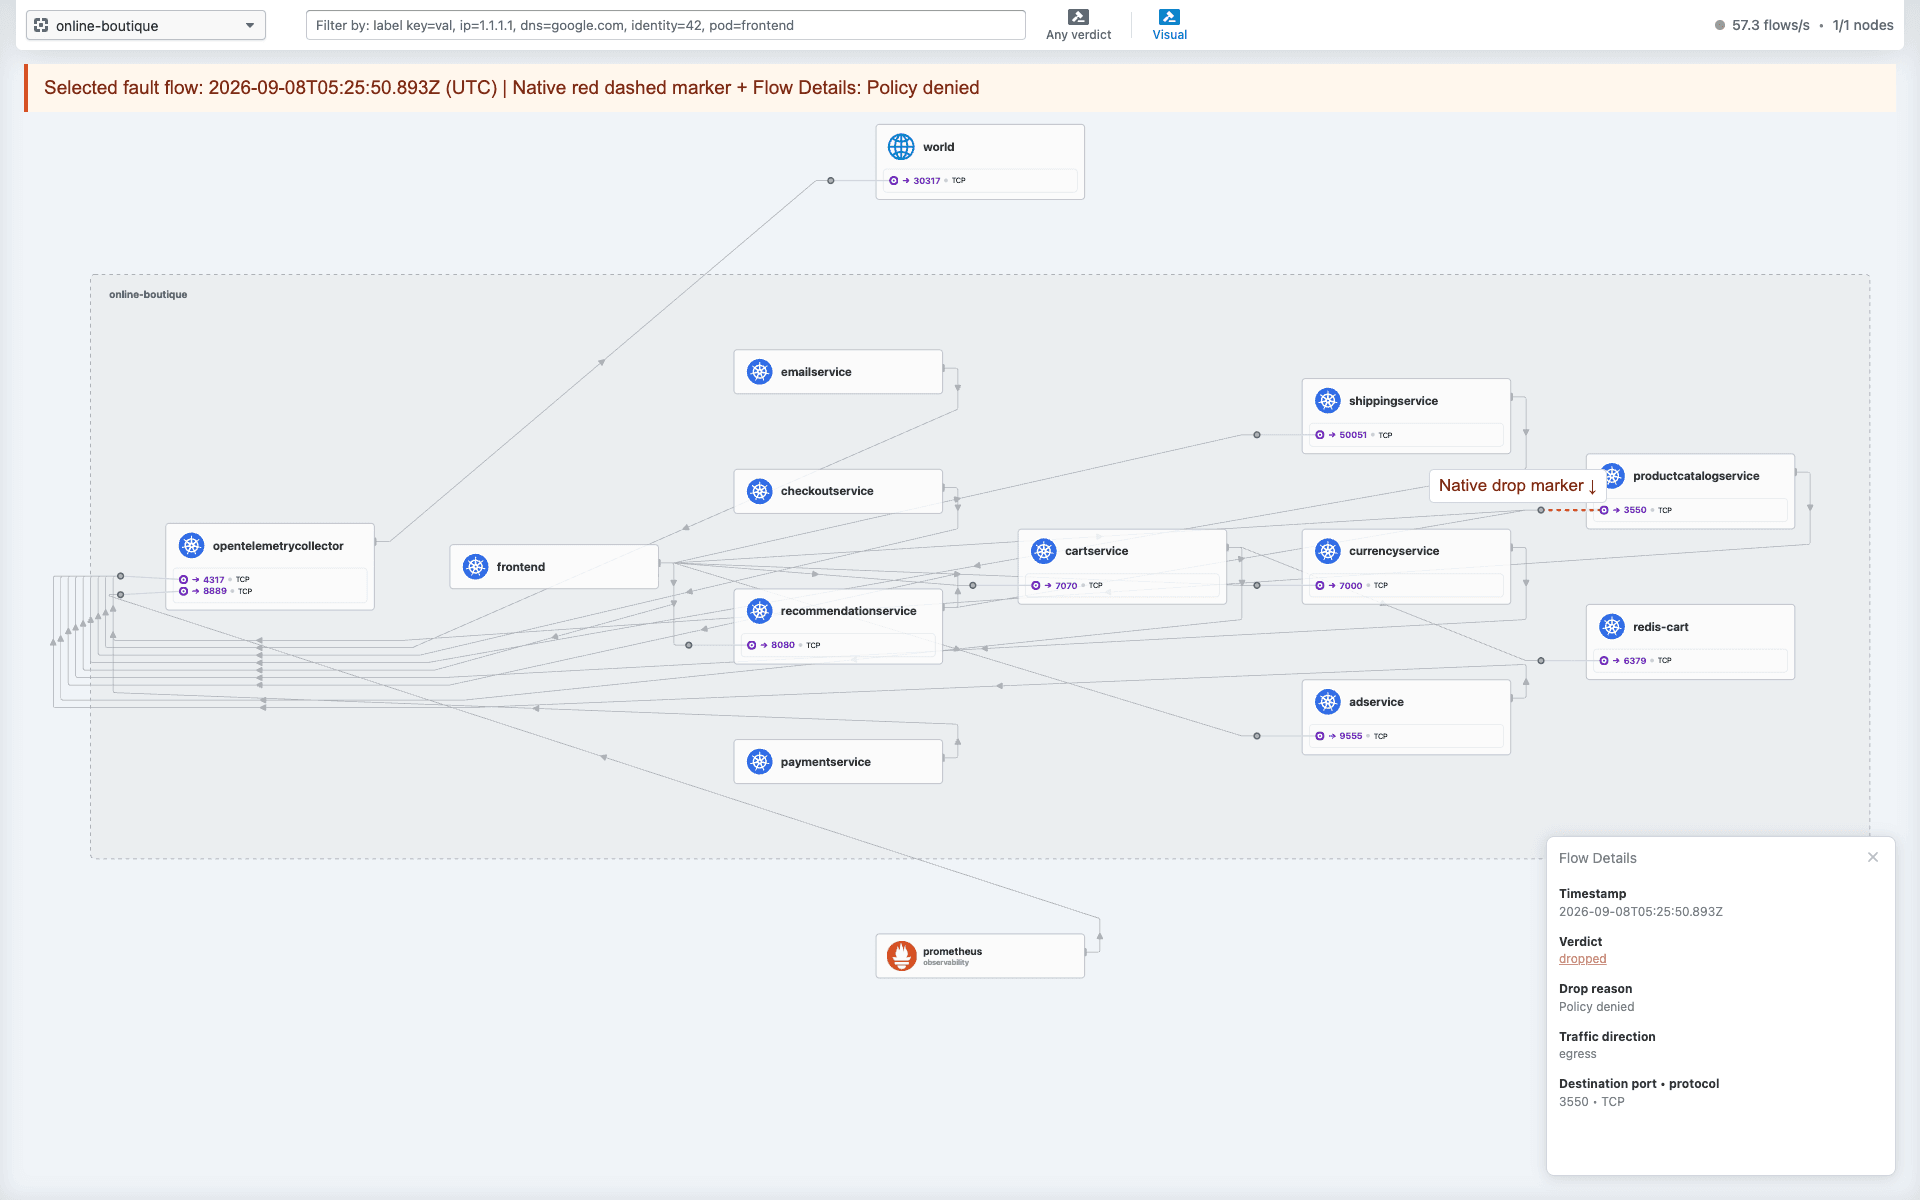
상품 조회 경로에서 관측한 Policy denied flow.
이 실험은 Pod가 살아 있다는 사실과 실제 서비스 의존 경로가 정상이라는 사실을 구분해서 보게 해줬다. 상태 조회만으로는 놓칠 수 있는 연결 문제를 Hubble flow로 확인할 수 있었다.
Hubble Provider는 이 관측을 Evidence로 만들고 StateGraph와 Frozen Context에 전달한다. 다만 현재 검증 범위는 정책 차단 관측의 수집과 전달까지다. 네트워크 원인을 확정하는 taxonomy와 Gate 규칙까지 완성한 것은 아니다. flow가 조회되지 않는 경우도 정상 통신으로 단정할 수 없다. Hubble buffer에 필요한 과거 기록이 남아 있는지 별도로 확인해야 한다.
No-Fault Control: Knowing When to Abstain
정상 traffic만 흘리는 no-fault 대조군도 함께 실행했다. 이 경우 분석 작업이 성공했다는 이유만으로 root cause를 채우면 안 된다.
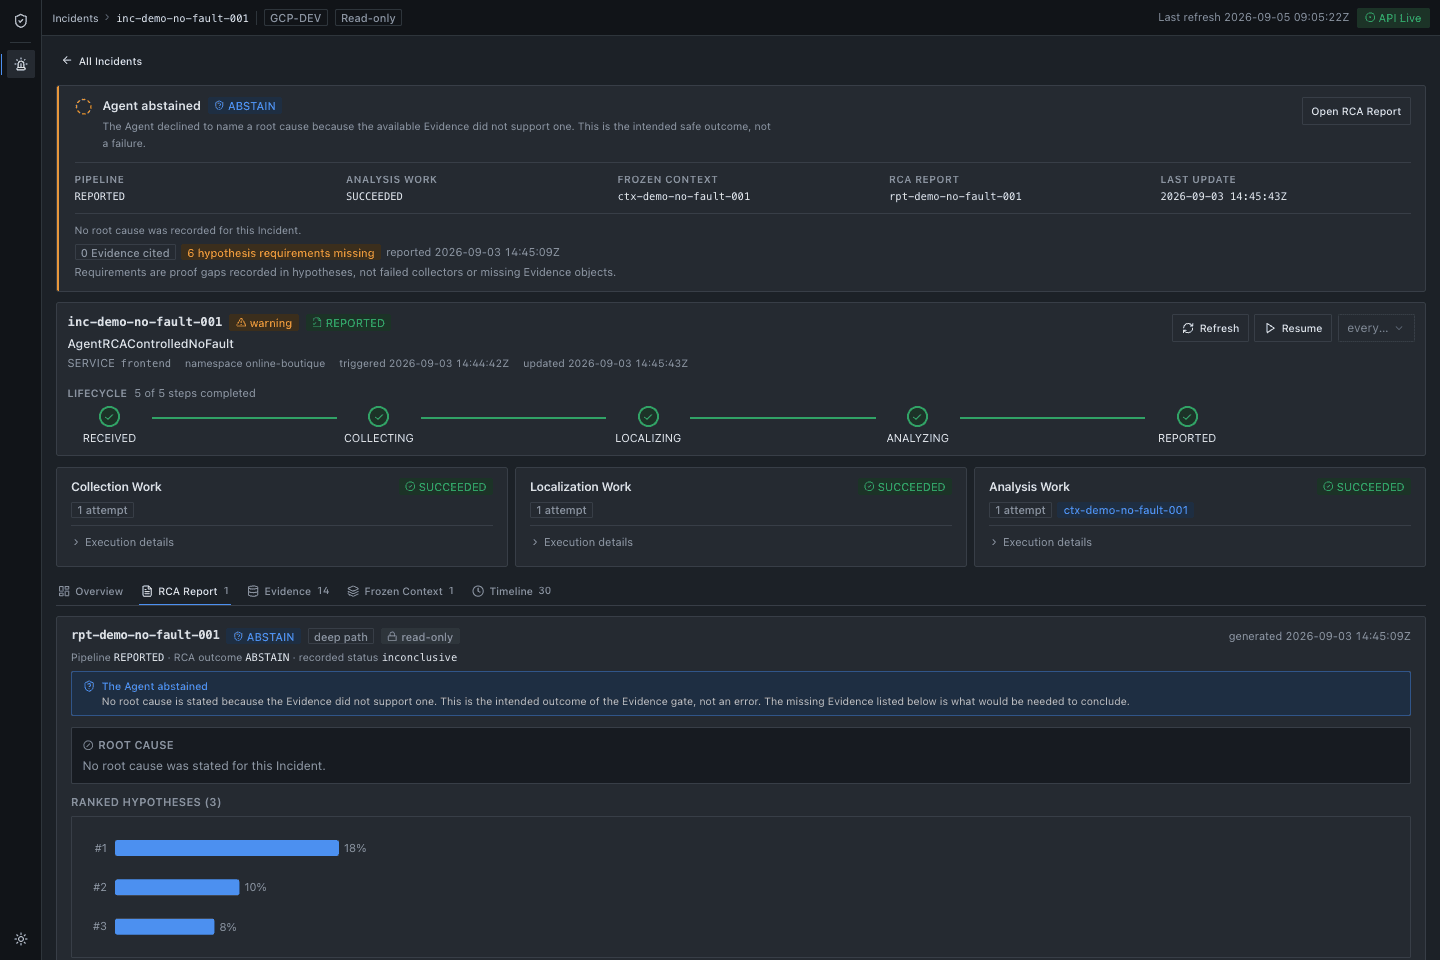
no-fault 대조군에서 수락된 판단 유보 결과.
이때의 ABSTAIN은 “시스템 전체에 장애가 없다”는 보장이 아니다. 현재 조사한 Evidence로는 등록된 원인을 증명하지 못했다는 뜻이다.
What Failed and What I Changed
초기에는 OOM, ImagePullBackOff, missing ConfigMap, no-fault를 각각 5회씩 실행했다. 장애 주입과 정리는 20회 모두 완료됐지만, Agent 결과가 기대 outcome과 일치한 것은 9회였다. fault 15건의 원인 Top-1은 4건만 맞았다.
여기서 중요한 것은 실험 실행의 성공과 진단의 성공이 달랐다는 점이다. 실패 기록을 따라가 보니 충분한 Evidence가 있어도 Agent와 도구, Gate 사이에서 Report가 탈락하는 문제가 있었다.
| 확인한 문제 | 바꾼 부분 |
|---|---|
| 긴 Evidence ID를 tool 인자로 다시 입력하다가 오타 발생 | 모델에는 짧은 E1, E2 reference를 제공하고 도구가 실제 ID로 변환 |
| 오래된 Event나 다른 UID의 Event가 조회 개수를 먼저 소모 | kind·name·UID와 시간으로 제한하고 중복 집계를 output cap보다 먼저 적용 |
| Gate의 completeness 조건을 모델이 알지 못해 허용되지 않는 확정 결론 생성 | 수집 실패와 completeness 정책을 모델 입력에도 전달 |
| 원인 없는 가설을 evaluator가 예측 원인으로 계산 | supporting Evidence가 있는 가설만 예측 원인으로 계산 |
| Gate rejection 이유가 하나로 뭉쳐 원인 구분이 어려움 | 실패를 machine-readable reason code로 분리 |
특히 Evidence ID 문제는 LLM의 추론 능력을 높여서 해결할 문제가 아니었다. 모델이 긴 식별자를 정확히 복사해야만 도구를 쓸 수 있게 만든 인터페이스를 바꾸는 편이 직접적인 해결이었다. Report에서는 여전히 도구가 반환한 실제 Evidence ID만 인용하도록 했다.
수정 후에는 이전 결과를 다시 채점하지 않고 같은 등록 시나리오로 새로운 20회를 실행했다. 기대 outcome은 20/20, fault Top-1은 15/15, no-fault의 ABSTAIN은 5/5였다. 인용 검증과 Gate의 기준을 낮추지는 않았다.
그렇다고 한 번의 20/20으로 마무리할 수는 없었다. 미사용 parameter variant를 적용한 최초 holdout은 12/12였지만, 같은 조건을 다른 시점에 반복하자 11/12가 됐다. 실패한 1건은 근거를 읽고 인용했어도 최종 초안이 schema를 만족하지 못했다.
당시에는 실패한 field를 특정할 정보가 남아 있지 않았다. 그래서 이후 실패에는 원본 응답이나 민감한 값을 저장하지 않으면서도 JSON/schema 위치와 위반 keyword를 확인할 수 있도록 audit을 보강했다. structured output의 별도 8회 검증은 모두 수락됐지만, 이 결과로 과거 실패를 성공으로 바꾸거나 장기 신뢰성을 입증했다고 보지는 않는다.
이 과정에서 내가 중요하게 보게 된 것은 모델 답변의 품질뿐 아니라 모델이 정확히 사용할 수 있는 인터페이스와 실패를 설명할 수 있는 기록이었다. 도구 입력, 수집 범위, 출력 계약과 평가 의미가 서로 맞아야 진단 결과가 운영자에게 도달했다.
Results, Limitations, and Next Steps
현재 등록된 원인은 OOMKilled, image pull failure, missing ConfigMap 세 종류다. 평가에서는 장애를 주입한 쪽의 Ground Truth를 Agent 입력과 격리하고, 분석이 끝난 결과에만 결합해 채점했다.
| 검증 | 결과 | 해석 |
|---|---|---|
| 수정 전·후 matrix, 각 20회 | 기대 outcome 9/20 → 20/20 | 같은 등록 시나리오의 회귀 비교 |
| 최초 holdout / 시간차 반복, 각 12회 | 12/12 / 11/12 | 같은 원인군의 미사용 variant와 시간적 재현성 |
| structured output 재검증, 8회 | Report 수락 8/8 | 알려진 시나리오의 출력 계약 검증 |
| native OOM Alert, 1회 | Incident 수신 → Report 27초 | 실제 감지부터 Report까지 연결성 검증 |
반복 matrix는 장애를 확인한 뒤 평가용 Alert를 제출한 경로다. 반면 대표 native OOM 사례는 Prometheus rule이 실제 신호를 감지해서 Incident를 시작했다. 두 결과를 합쳐 자동 감지 성능이라고 설명할 수는 없다.
native 검증에서도 처음에는 기존 오류율 rule의 for: 2m 조건을 유지하지 못해 Incident가 만들어지지 않았다. 이후 별도의 OOM/restart rule로 연결성을 확인했다. 그 Alert는 OOM 신호를 감지하도록 설계됐으므로 사전 단서 없는 원인 식별 평가도 아니다. 27초 역시 Incident 수신 이후의 진단 시간이며, 장애 발생부터 복구까지의 MTTR은 아니다.
또 deterministic baseline도 같은 등록 시나리오에서 기대 outcome 20/20을 만족했다. 현재 결과만으로 LLM Agent가 규칙 기반 진단보다 정확하거나 효율적이라고 주장할 수 없다. 세부 실행 조건과 실패 기록은 Evaluation and Reliability Record에 남겼다.
다음으로 확인할 것은 관측 데이터가 일부 누락됐을 때의 동작이다. 현재 구조를 유지한 상태에서 API metric이 없거나 일부 feature만 수집된 경우에도 실제 원인 대상과 필요한 Evidence가 조사 범위에 남는지 검증하려고 한다.
모든 Evidence에 같은 점수를 적용하는 것이 목표는 아니다. KRCA는 API 시계열을 바탕으로 서비스 조사 범위를 좁히고, Kubernetes 상태와 Hubble flow는 Context에 포함된 경우 각자의 관측 의미에 따라 조사 근거로 사용한다. 먼저 이 조합에서 실제 누락 사례가 발생하는지 확인하고, 문제가 재현되는 지점에 한해 후보 선택이나 추가 수집을 보완하려고 한다. 네트워크 원인 확정에는 후보 선택과 별도로 taxonomy와 Gate의 증명 조건도 필요하다.
검증에서는 동일한 조회·분석 예산 아래 원인 대상의 후보 포함 여부, 최종 판단, 불필요한 조회와 판단 유보를 함께 비교할 계획이다. 구조 확장 자체보다 관측 누락이 진단에 미치는 영향을 확인하고 필요한 만큼 개선하는 데 집중하려고 한다.
이 프로젝트를 통해 내가 다루고 싶었던 인프라 문제는 관측 도구를 많이 설치하는 것에서 한 단계 더 나아간다. 장애 시점의 정보가 분석 시스템에 어떻게 도착하고, 어떤 이유로 선택되며, 그 결론을 운영자가 다시 확인할 수 있는지까지 연결하는 것이다. 그 연결을 실제 장애와 실패 기록으로 확인한 것이 이번 구축의 가장 큰 결과라고 생각한다.